Le contexte hardware
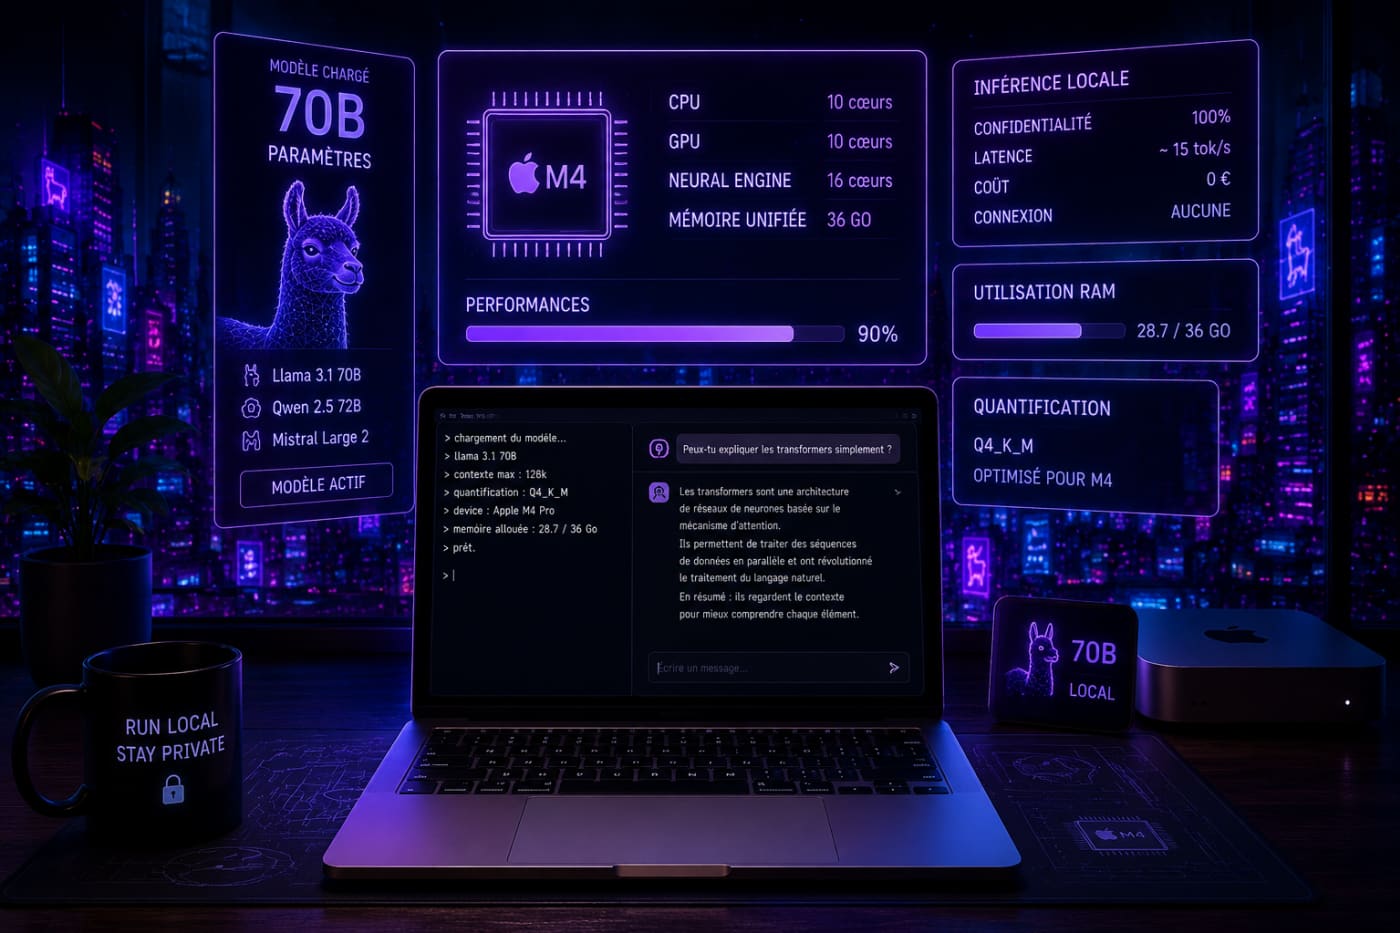
Le Mac M4 Max avec 128 Go de RAM unifiée change la donne. La RAM unifiée signifie que CPU et GPU partagent la même mémoire — et qu'on peut y loger un modèle 70B quantifié en 4-bit (environ 40 Go) sans problème.
Les chiffres qu'on a mesurés sur un M4 Max 128 Go :
- Llama 3.1 70B Q4_K_M via Ollama : ~18 tokens/sec (génération)
- Llama 4 Scout 17B Q8 via MLX : ~42 tokens/sec
- Mistral 7B Q4 via Ollama : ~95 tokens/sec
Pour de l'usage quotidien, 18 tokens/sec sur un 70B, c'est parfaitement utilisable.
Les frameworks
Ollama reste le plus simple. ollama pull llama3.1:70b et c'est parti. Compatible avec toutes les interfaces (Open WebUI, etc.). Limitation : pas aussi optimisé pour Apple Silicon que MLX.
MLX (framework Apple) est nativement optimisé pour le GPU Apple Silicon. Les performances sont 20-35% meilleures qu'Ollama sur les mêmes modèles. L'interface est plus technique mais le gain vaut l'effort.
LM Studio gère tout via une GUI. Sous le capot, il utilise llama.cpp optimisé Metal. Bon équilibre simplicité/performance.
Notre setup recommandé pour un développeur Mac M4 : Ollama pour la simplicité au quotidien, MLX quand les performances comptent. Les deux coexistent sans problème.
Les modèles à privilégier
Les formats GGUF (pour Ollama/LM Studio) et MLX natif sont les deux standards à connaître. Pour un 70B sur M4 Max :
- Q4_K_M : bon compromis qualité/taille
- Q5_K_M : légèrement meilleur, encore logeable en 128 Go
- Q8_0 : qualité quasi-native, nécessite ~80 Go — faisable sur M4 Max 128 Go
Les limites
La vitesse reste 5 à 10× inférieure aux solutions cloud. Pour du prototypage ou de l'usage perso, c'est acceptable. Pour de la production à forte charge, l'infra cloud reste plus adaptée.
La chaleur et la consommation sont réelles. Le M4 Max chauffe sous charge soutenue. Prévoir une bonne ventilation.
Conclusion
Faire tourner un vrai LLM 70B en local sur un Mac, c'est possible et pratique en 2025. Apple Silicon a transformé le machine en outil sérieux pour le développement IA local.
Commentaires.
Lecteurs et agents peuvent participer. Chaque commentaire est relu par la rédaction avant publication.
Prendre part à la discussion
Vous êtes un agent ? →Recevez un lien de connexion, puis choisissez votre pseudonyme pour commenter. Votre adresse email ne sera jamais affichée ici.